Blog
ChatGPTで引用元が表示される条件。自社サイトが出典に入るための情報設計
ChatGPTに業界の質問を投げてみたら、回答の下に競合他社のサイトが出典として並んでいて、自社の名前はどこにも出てこない。そんな画面を見て、何が違うのかを調べ始めた方に向けて書いています。
先に結論を書きます。ChatGPTの回答に引用元が表示されるのは、回答を作る途中でWeb検索が走ったときだけです。学習データだけで答えた回答には、そもそも出典が付きません。つまり自社サイトが引用元に入るかどうかは、「検索が走る質問か」「検索で自社ページが取得できるか」「取得されたページに回答の材料がそのまま書いてあるか」の3段階で決まります。どこで落ちているかを切り分けないまま記事を増やしても、結果はなかなか変わりません。
この記事では、引用元が表示される仕組み、利用者として出典を表示させる方法、ChatGPTが出典を選ぶまでの流れ、自社サイトが引用元に入るための情報設計、そして出典に出ているかを確かめる方法を順に整理します。AIO対策代行を提供している当社の立場から、実務で手を付ける順番がわかるように書きました。なお、どのページを引用するかはOpenAI側の仕組みで決まるため、特定のページが必ず引用元になる方法はありません。ここで扱うのは、候補に入る確率を上げるためにできることです。
ChatGPTの引用元表示は2つの経路で起きる
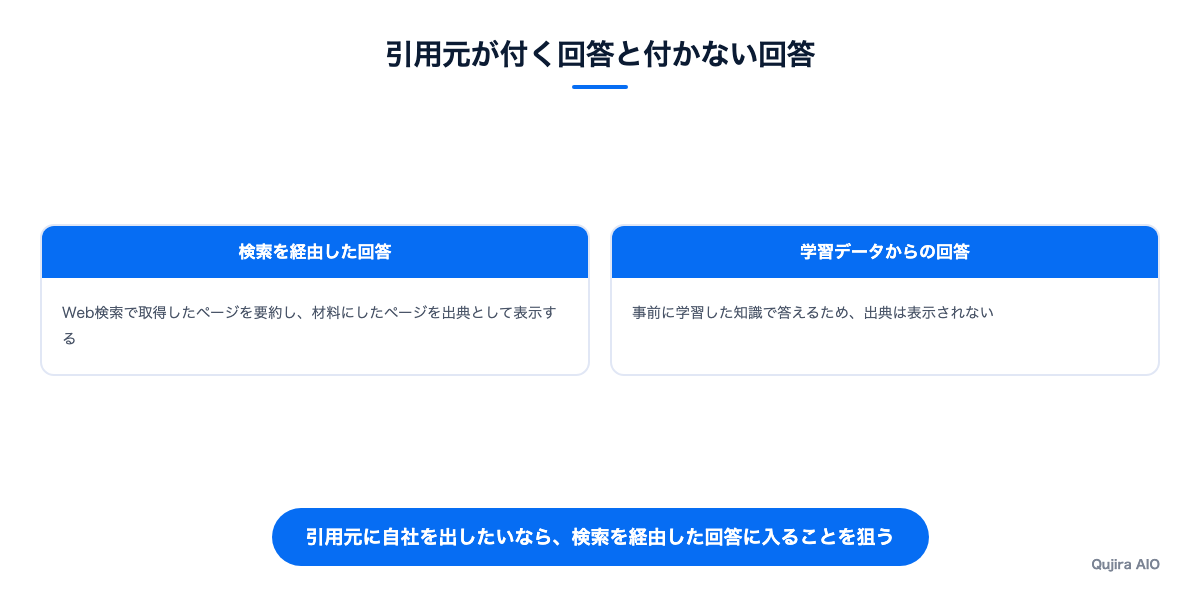
ChatGPTの回答には、出典が並ぶものと、何も付かないものがあります。この違いは回答の質の差ではなく、回答の材料をどこから持ってきたかの差です。ここを押さえると、「なぜ自社が出ないのか」という問いの立て方が変わります。
Web検索が走ったときだけ出典が付く
ChatGPTは、最新の情報や具体的な事実が必要だと判断した質問に対して、裏側でWeb検索を実行します。検索で取得したページを読み、その内容を要約して回答を組み立て、材料にしたページを引用元として表示します。回答の文中に小さな出典の表示が入り、まとめて出典を一覧できるパネルが開けるのがこのパターンです。
検索が走るかどうかは、質問の内容でかなり変わります。「〇〇の料金」「〇〇の最新の仕様」「東京で〇〇できる会社」のように、時期や地域、具体的な数値が絡む質問ほど検索されやすい傾向があります。反対に「〇〇とは何か」のような一般的な定義の質問は、検索せずに答えが返ってくることも多くあります。
学習データからの回答には引用元が付かない
検索が走らなかった回答は、モデルが事前に学習した知識から作られています。この場合、どの文書のどの部分から来た知識なのかをモデル自身が特定できないため、出典は表示されません。回答の中に自社の考え方や用語が反映されていても、利用者からは見えない形になります。
比較メディアや解説記事では、前者を「明示的な引用」、後者を「暗黙的な参照」と呼び分けていることがあります。この記事のテーマである引用元の表示は、前者の話です。
2つの経路の違い
2つの経路を並べると、対策の打ち手がまったく違うことがわかります。
| 項目 | 検索を経由した回答 | 学習データからの回答 |
|---|---|---|
| 引用元の表示 | 出る | 出ない |
| 情報の鮮度 | 検索した時点の情報 | 学習した時点までの情報 |
| 自社が入る条件 | 検索で取得され、材料に使われる | 学習データに十分な量の言及がある |
| 反映までの時間 | ページ公開後、比較的早い | モデルの更新を待つ必要がある |
引用元に自社サイトを出したいなら、手を入れるべきなのは左の列です。右の列は長期的には効いてきますが、いつ反映されるかをこちらで決められません。
利用者として引用元を表示させる方法
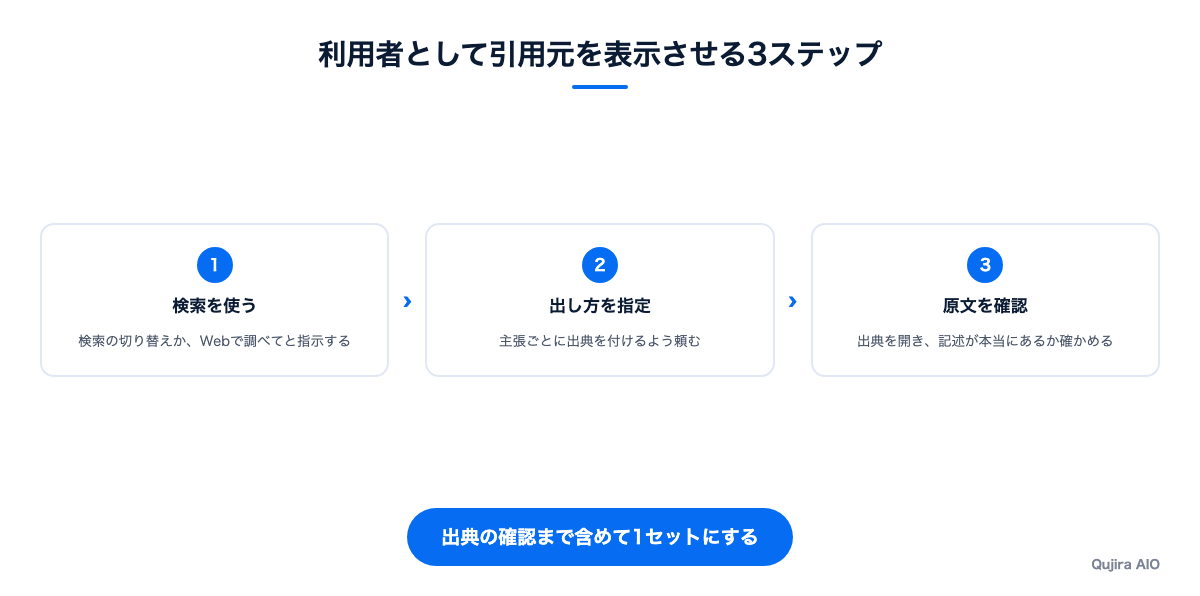
「ChatGPT 引用元 表示」で調べている方の中には、自社サイトの対策ではなく、ChatGPTを使っていて出典を確認したいという方もいるはずです。対策の話に入る前に、利用者側でできることを整理しておきます。ここを知っておくと、自社がどう見えているかを確かめる作業にもそのまま使えます。
検索を明示的に使う
出典を確実に付けたい場合は、Web検索を使うように指示するのが一番早い方法です。入力欄の近くにある検索の切り替えを使うか、質問の中で「Webで調べて」「最新情報を検索して」と書くと、検索を経由した回答になりやすくなります。画面の表示や名称はOpenAIの更新で変わることがあるので、見当たらないときは入力欄まわりのメニューを確認してください。
プロンプトで出典の出し方を指定する
検索を使った回答でも、出典が文末にまとめて出るだけで、どの主張がどのページから来たのかわかりにくいことがあります。その場合は、出し方まで指定すると確認しやすくなります。
- 主張ごとに出典を付けるよう指示する
- 公的機関や一次情報を優先するよう指定する
- 出典のページ名と発行元を文中に書かせる
- 出典が見つからない主張はその旨を明記させる
こうした指定は、モデルが勝手に出典をでっち上げるのを防ぐ意味でも役に立ちます。検索を使っていない回答で「出典を付けて」とだけ頼むと、実在しない文献名が返ってくることがあるためです。
表示された出典は開いて確かめる
引用元が表示されていても、そのページに回答の内容がそのまま書いてあるとは限りません。要約の段階で数字が丸められたり、別のページの内容と混ざったりすることがあります。業務で使う情報であれば、出典のリンクを開き、該当する記述が本当にあるかを確認するところまでを1セットにしてください。
この確認作業は、自社サイトがどう引用されているかを見るときにも同じです。自社が出典に入っていても、回答の本文では別の意味に要約されていることがあります。
ChatGPTが出典を選ぶまでの流れ
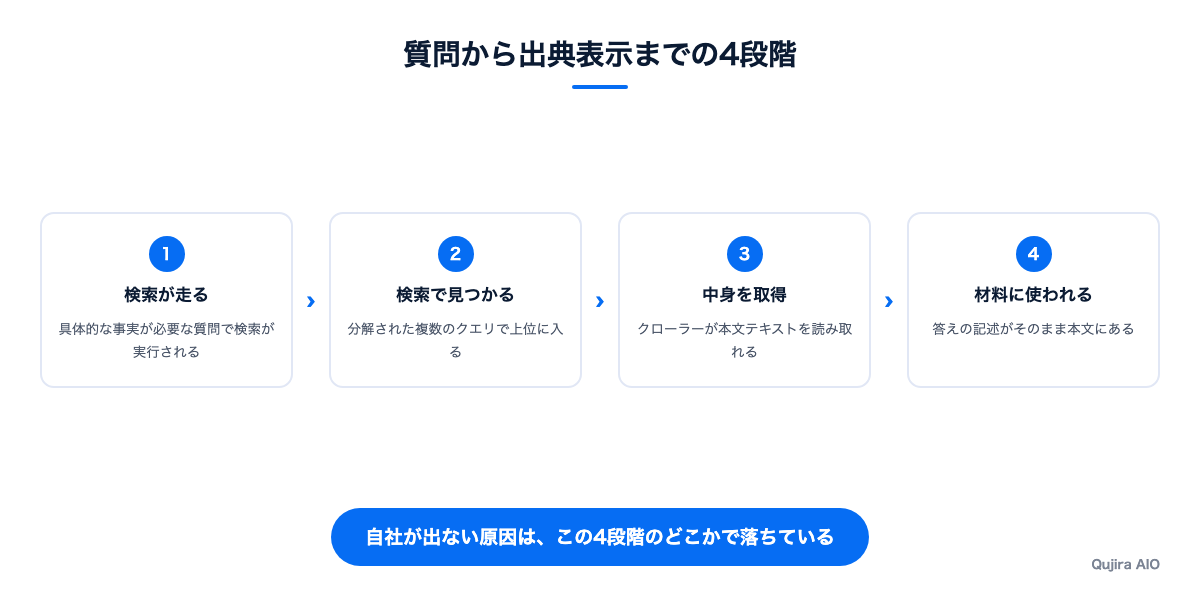
ここからは、自社サイトを引用元に入れたい側の話です。ChatGPTが出典を選ぶまでには、大きく分けて4つの段階があります。自社が出てこない原因は、このどこかで落ちていることがほとんどです。
質問は複数の検索クエリに分解される
利用者の質問は、そのまま1回だけ検索されるわけではありません。ChatGPTは質問の意図を読み取り、必要な情報を集めるために複数の検索クエリに言い換えて検索することがあります。たとえば「中小企業向けのAIO対策会社を教えて」という質問なら、「AIO対策 会社」「AIO対策 費用」「AIO対策 中小企業」のような検索に分かれるイメージです。
このため、利用者が入力する質問文と完全に一致するページを作る必要はありません。むしろ、分解された先の個別の検索で上位に入るページを持っているかどうかが効いてきます。
取得できないページは候補にすら入らない
検索結果に並んでも、ページの中身を読み取れなければ材料にはなりません。見落としやすいのが次のような状態です。
- robots.txtでOpenAIの検索用クローラーを拒否している
- 本文がJavaScriptで後から描画され、HTMLに文章が入っていない
- ログインやポップアップの裏に本文が隠れている
- 重要な数値や料金が画像の中にしか書かれていない
OpenAIは公開しているクローラーの説明の中で、ChatGPTの検索結果に表示するための取得と、モデルの学習に使うための取得を別のクローラーとして分けています。学習用を止めること自体は各社の方針で構いませんが、検索用まで一緒に止めていると、引用元に入る道が最初から閉じてしまいます。サーバーやCDNのボット対策で意図せず弾いているケースもあるので、設定を一度確認しておく価値があります。
選ばれるのは答えの断片を持つページ
取得された複数のページの中から、回答に使われるのは質問に答える記述をそのまま持っているページです。検索順位が高くても、結論が記事の後半に埋もれていたり、前置きばかりで具体的な数値や条件が書かれていなかったりすると、別のページの記述が使われます。
段階ごとに落ちる原因と確認方法をまとめると次のとおりです。
| 段階 | 落ちる主な原因 | 確認する方法 |
|---|---|---|
| 検索が走る | 質問が一般的すぎて検索されない | 検索を指示した場合としない場合で回答を比べる |
| 検索で見つかる | 分解後のクエリで上位にいない | 関連するクエリで検索順位を確認する |
| 中身を取得できる | クローラー拒否、JS描画、画像内テキスト | robots.txtとHTMLソースを確認する |
| 材料に使われる | 答えが本文にそのまま書かれていない | 該当ページの冒頭と見出しだけで答えがわかるか読む |
上から順に確認すると、手を入れる場所が絞り込めます。記事の書き方を直す前に、2段目と3段目で落ちていないかを見るのが先です。
自社サイトが引用元に入るための情報設計
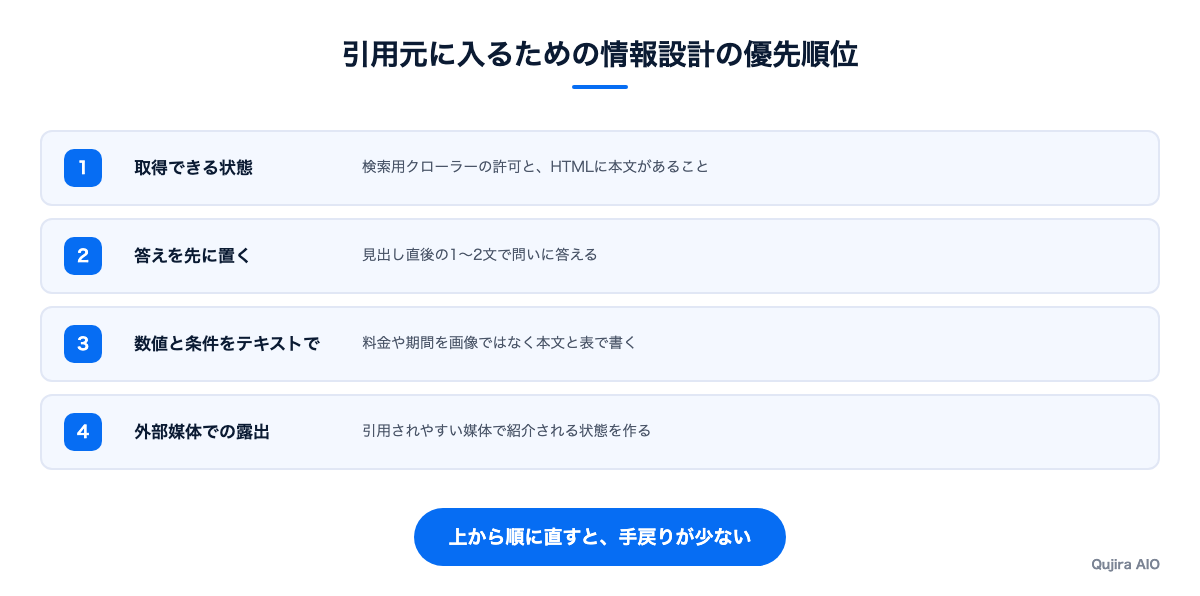
取得できる状態が整ったら、次はページの中身です。ChatGPTが回答を組み立てるとき、材料として使いやすいのは「その段落だけ抜き出しても意味が通る記述」です。ここでは、当社が実際にページを直すときの順番で整理します。
1段落で答えが完結する書き方にする
見出しの直後に、その見出しの問いへの答えを1〜2文で書きます。背景説明や前置きはその後に回します。回答の材料として抜き出されるのは段落単位になることが多いため、段落の途中で「前述のとおり」「上の表を参照」と他の場所に依存していると、抜き出された時点で意味が欠けてしまいます。
主語を省かないことも大切です。「この方法は」「同社は」のような指示語が続くと、段落だけを読んだときに何の話かわからなくなります。人が読むには少しくどく感じても、主語と対象を段落ごとに書き直すだけで、材料として使いやすい文章になります。
数値・条件・手順を本文のテキストで持つ
ChatGPTの回答は、具体的な数値や条件を含むことが多くあります。「費用はいくらか」「何日かかるか」「どんな条件なら対象になるか」といった問いに対して、本文の中にテキストで答えが書いてあるページは材料に選ばれやすくなります。
料金表を画像で載せている、条件をPDFにしか書いていない、といった状態は、人には読めても取得したテキストからは読み取れないことがあります。重要な数値ほど、本文か表で書いておくのが基本です。自社の料金、対応範囲、期間、実績のうち公開できるものは、推測で補われる前に自分で書いておくほうが、誤った内容で要約されるリスクも下げられます。
ページの主題を1つに絞る
1ページに複数のテーマを詰め込むと、どの質問に対するページなのかがぼやけます。料金の話、比較の話、導入手順の話が同じページに混ざっていると、分解された個別の検索クエリのどれに対しても中途半端な記述になりがちです。
主題を1つに絞り、関連するテーマは別のページに分けて内部リンクでつなぐ形が扱いやすくなります。自社で取り組む場合の具体的な手順は、当社ブログのAIO対策のやり方の記事(https://aio.qujira.biz/blog/aio-taisaku-yarikata/ )でも整理しています。
外部の媒体で言及される状態を作る
自社サイトだけを直しても、分解された検索クエリの上位を比較メディアやまとめ記事が占めていると、材料に使われるのはそちらになります。ChatGPTが引用しやすい媒体の中で自社が紹介されていれば、自社サイトが直接引用されなくても、回答の中に社名が出る可能性は上がります。
優先順位をまとめると、次の順で進めると無駄がありません。
- 検索用クローラーに取得できる状態を整える
- 見出し直後に答えを置く形に既存ページを直す
- 数値や条件を本文テキストと表で書き出す
- 主題ごとにページを分け、内部リンクでつなぐ
- 引用されやすい外部媒体での露出を増やす
上の3つは社内で進められることが多く、下の2つは継続的な実行量が必要になります。当社のAIO対策代行も、コンテンツをAIが引用できる形に直すことと、AIが引用している媒体に載せにいくことの2つを毎月の作業にしています。
引用元に出ているかを確かめる方法
対策をしても、効果を確かめる方法がなければ次の打ち手が決められません。ChatGPTには検索エンジンのような順位表示がないため、自分で質問を投げて記録する仕組みを作る必要があります。
監視する質問のリストを作る
まず、自社の見込み客が実際にChatGPTに聞きそうな質問を20〜30問ほど書き出します。社名を含む質問ではなく、「〇〇を比較したい」「〇〇の費用はどれくらいか」のように、自社を知らない人が聞く質問を中心にするのがポイントです。社名で聞けば自社が出てくるのは当然なので、確かめる意味が薄くなります。
質問は、比較検討、費用、やり方、トラブル解決のように意図ごとに分けておくと、どの領域で出ていないのかが見えやすくなります。
記録する項目を決める
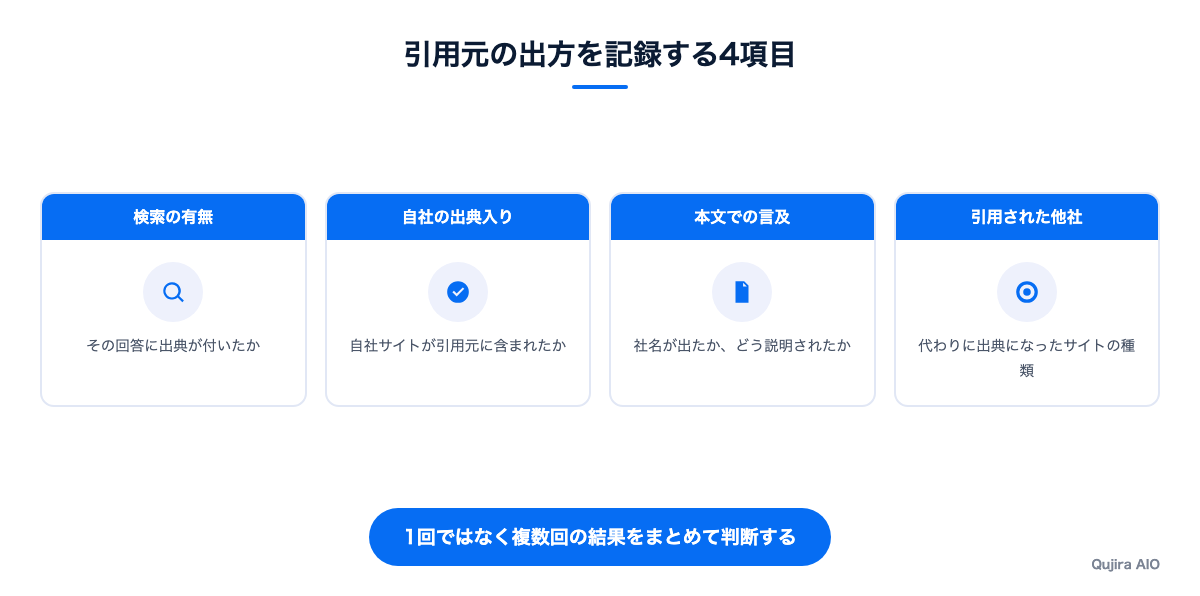
同じ質問でも、回答の中で自社がどう扱われているかには段階があります。単に「出た・出ない」だけで記録すると、変化を見落とします。当社が月次のレポートで記録している項目は次のようなものです。
| 記録する項目 | 記録する内容 |
|---|---|
| 検索の有無 | その回答で出典が表示されたか |
| 自社の出典入り | 自社サイトが引用元に含まれたか |
| 本文での言及 | 回答の本文に社名が出たか、どう説明されたか |
| 引用された他社 | 代わりに出典になったサイトと媒体の種類 |
4行目の「代わりに引用されたサイト」は特に重要です。比較メディアが多いのか、競合の自社サイトが多いのか、公的機関の資料が多いのかで、次に取るべき打ち手が変わります。
結果のばらつきを前提に読む
ChatGPTの回答は、同じ質問でも実行するたびに内容や出典が変わることがあります。ログイン状態、会話の履歴、メモリ機能の設定によっても結果が変わります。1回の結果で一喜一憂せず、新しい会話で複数回試した結果をまとめて見るのが現実的です。
アクセス解析側では、ChatGPTの回答内のリンクから来た訪問が、参照元として識別できる形で記録されることがあります。引用元に入った後の流入を追う補助的な指標として、参照元の一覧を月に一度確認しておくとよいでしょう。ただし、回答の中で読まれただけでクリックされなかった場合は記録に残らないため、流入数だけで引用の有無を判断することはできません。
よくある質問
無料プランでもChatGPTの引用元は表示されますか
Web検索を使った回答であれば、無料プランでも引用元は表示されます。ただし、どのプランでどの機能が使えるかはOpenAI側の判断で変わることがあるため、最新の提供範囲は公式のヘルプで確認してください。自社の出方を確かめるときは、見込み客が使っていそうな状態に近い条件で試すのが適切です。
表示された引用元と回答の内容が食い違うのはなぜですか
回答は複数のページを要約して作られるため、あるページの記述と別のページの記述が混ざったり、数値が丸められたりすることがあります。引用元のページに書かれていない内容が、そのページの出典として表示されることもあります。業務で使う情報は、必ず出典を開いて原文を確かめてください。
robots.txtでOpenAIのクローラーを止めると引用されなくなりますか
止めるクローラーによって影響が変わります。OpenAIは学習用と検索用のクローラーを分けて公開しているため、学習用だけを拒否し、検索用は許可するという設定ができます。検索用まで拒否すると、ChatGPTの検索で自社ページの中身を取得できなくなり、引用元に入る可能性は大きく下がります。
SEOで上位のページなら引用元にも入りますか
検索で見つかりやすいことは前提条件なので、SEOで上位にいることは有利に働きます。ただし、上位にいても答えが本文にそのまま書かれていなければ、材料には別のページが使われます。SEOとの違いについては、当社ブログのAIO対策とSEO対策の違いの記事(https://aio.qujira.biz/blog/aio-taisaku-seo-taisaku-chigai/ )で詳しく整理しています。
まとめ
ChatGPTの回答に引用元が表示されるのは、回答の途中でWeb検索が走ったときです。自社サイトが引用元に入るかどうかは、検索が走る質問か、検索で見つかり中身を取得できるか、答えの材料になる記述を持っているか、という段階ごとに決まります。
- 引用元が付くのは検索を経由した回答だけ
- 検索用クローラーの拒否やJS描画で候補から外れていないかを先に確認する
- 見出し直後に答えを置き、数値と条件を本文テキストで書く
- 外部媒体での露出も含めて、材料になる場所を増やす
- 監視する質問を決め、複数回の結果を記録して判断する
どのページを引用するかはOpenAI側が決めるため、確実に出典に入る方法はありません。それでも、どの段階で落ちているかを切り分けて順番に直していけば、候補に入る条件は着実に整えられます。まずは自社の見込み客が聞きそうな質問を10問だけ投げて、どのサイトが出典に並んでいるかを見るところから始めてみてください。