Blog
AI検索に引用されない原因は3層で切り分ける。確認の順番と直し方
AI検索で自社のことを聞いても、答えに出てくるのは競合のページばかりで、自社サイトは引用元に一度も並ばない。そんな状況で原因を探している方に向けて書いています。
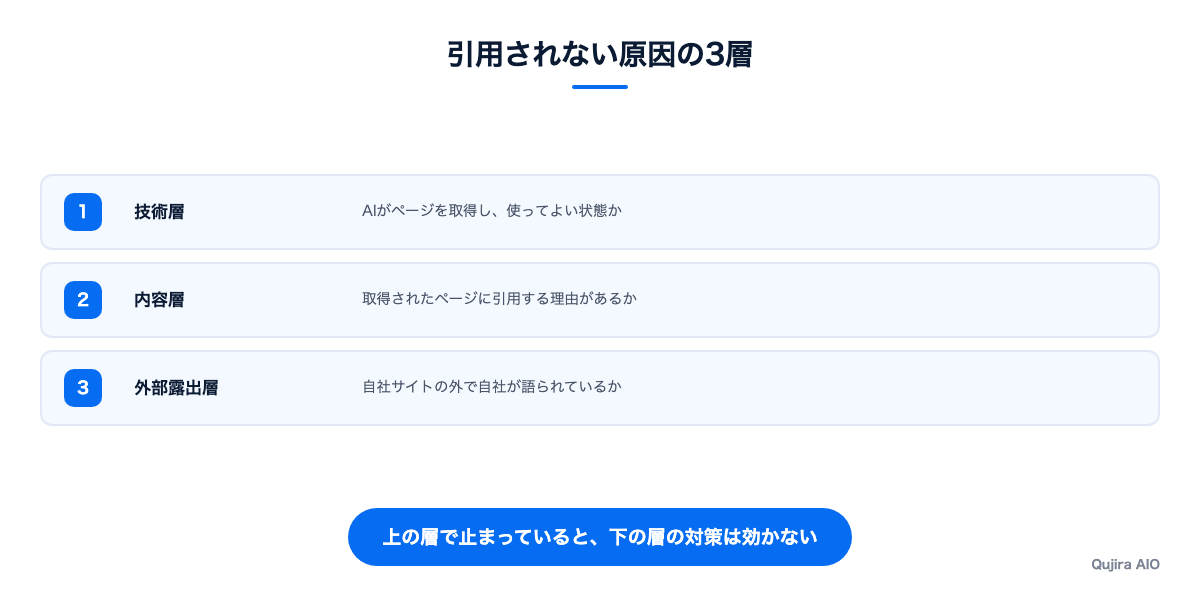
先に結論を書きます。AI検索に引用されない原因は、技術、内容、外部露出の3層に切り分けられます。技術層はAIがそもそもページを取得して使えるか、内容層は取得したページに引用する理由があるか、外部露出層は自社サイトの外で自社がどう語られているか、という問題です。そして、この3層は上から順に確認するのが効率的です。技術層で止まっているサイトに記事の書き直しをしても結果は変わらず、内容層が弱いまま外部露出を増やしても、AIが自社ページを選ぶ理由は生まれないからです。
この記事では、3層それぞれで起きやすい原因と確認方法、切り分けの手順、直す順番までを扱います。当社はAIO対策代行を提供しており、無料診断でも同じ順番でサイトを見ています。ただし、どの対策をしても引用されると保証できるものではありません。AIがどの情報源を使うかは各社の仕組みの中で決まり、外から操作できる範囲には限りがあります。その前提で、打てる手を漏れなく打つための考え方としてお読みください。
AI検索に引用されない原因は3層に切り分けられる
技術・内容・外部露出の3層とは
AI検索が回答を作るとき、大まかには「候補になる情報を集める」「その中から回答に使う情報を選ぶ」「回答を書いて出典を添える」という流れをたどります。引用されないという結果は、この流れのどこかで自社の情報が落ちているということです。落ちる場所に合わせて原因を分けると、次の3層になります。
| 層 | 問われていること | 代表的な原因 |
|---|---|---|
| 技術層 | AIがページを取得し、使ってよい状態か | インデックス未登録、クローラーの遮断、スニペット制限 |
| 内容層 | 取得されたページに引用する理由があるか | 答えが見つからない、一般論ばかり、主題の分散 |
| 外部露出層 | 自社サイトの外で自社が語られているか | 第三者媒体に名前がない、会社情報の不一致 |
競合記事の多くは原因を5個や10個の並列リストで紹介していますが、並列で見ると「どれから手をつけるか」が決まりません。層に分けると、前の層が解決していないと次の層の対策が効かない、という依存関係が見えるようになります。
上の層から順に確認する理由
技術層の問題は、ほかの対策の効果をまるごと打ち消します。たとえばGoogleは、AIによる概要やAIモードで補足リンクとして表示される条件として、ページがインデックスに登録され、通常の検索結果でスニペット付きで表示できる状態であることを挙げています。つまり、スニペットを出さない設定が入っているページは、どれだけ内容を磨いても候補に入りません。
内容層と外部露出層の関係も同じです。外部の媒体で自社名が話題になっても、自社サイトに質問への明確な答えが無ければ、AIが引用するのは話題にした側の媒体になります。確認の順番を守るだけで、効かない作業に時間を使う事態はかなり減らせます。
引用されないと判断する前に測り方を確認する
原因を探す前に、本当に引用されていないのかを確かめる必要があります。AI検索の回答は、同じ質問でも聞くたびに、また利用者の地域や会話の履歴によって変わります。1回聞いて出なかったから引用されていない、と判断するのは早すぎます。
- 質問文を固定し、同じ条件で複数回確認しているか
- ChatGPT、Gemini、Perplexity、GoogleのAIによる概要を分けて見ているか
- 自社名で聞く質問と、自社名を含まない質問を分けているか
- 記録を残し、週単位や月単位で比べられる状態か
このうち1つでも欠けていると、改善しても効果を判断できません。測り方をそろえることは、原因の切り分けそのものより先にやるべき作業です。
技術層:AIがページを取得・利用できていない
インデックスとスニペットの設定
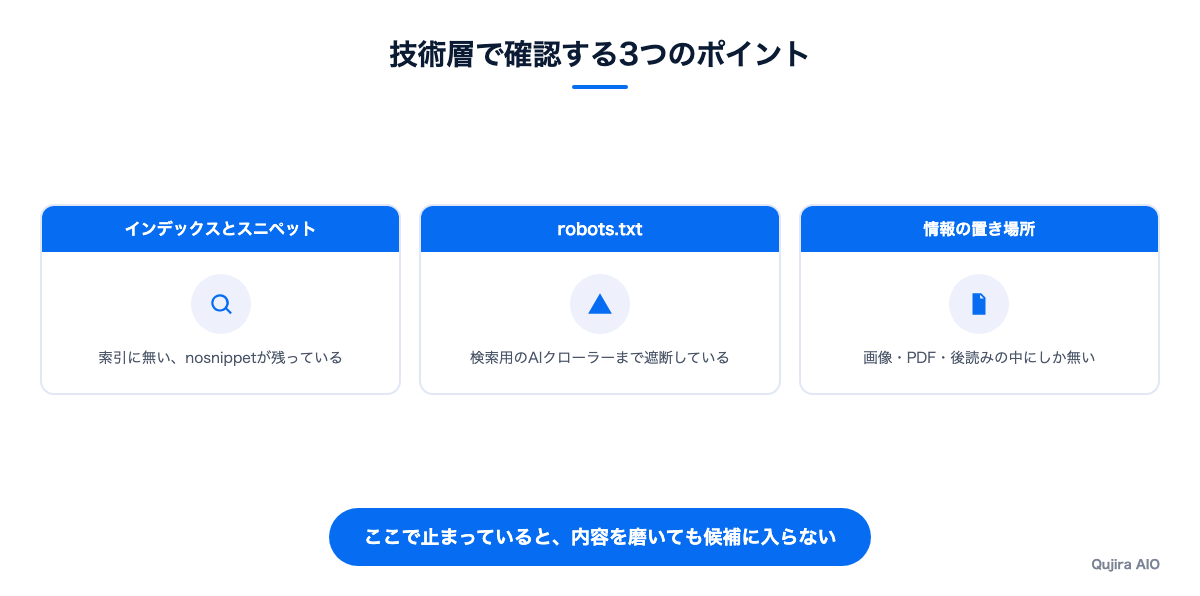
最初に確認するのは、引用されてほしいページが検索エンジンにインデックスされているかどうかです。GoogleのAIによる概要やAIモード、MicrosoftのCopilotのように検索エンジンの索引を土台にしているAI検索では、索引に無いページは候補になりません。Google Search Consoleのページのインデックス登録レポートや、URL検査で個別に確かめられます。
見落としやすいのがスニペットの制御です。meta robotsのnosnippetやmax-snippet、HTMLのdata-nosnippet属性は、Googleの説明ではAIによる概要などの生成AI機能にも適用されます。過去にデザイン上の理由や情報漏えい対策で入れた設定が残っていて、それが原因になっている例は珍しくありません。
robots.txtとAIのクローラー
AI検索の各社は、検索用のクローラーを公開しています。robots.txtでこれらを遮断していると、その会社のAI検索で自社ページが候補から外れる可能性があります。一方で、学習用のクローラーは検索用とは別になっていることが多く、名前が似ているため取り違えが起きやすい部分です。
| クローラー名 | 運営元 | 主な役割(各社の公開説明による) |
|---|---|---|
| Googlebot | 検索の索引作成。AIによる概要もこの索引を使う | |
| Google-Extended | Geminiなどの学習や回答生成への利用可否の制御。検索への掲載には影響しないと説明されている | |
| OAI-SearchBot | OpenAI | ChatGPTの検索機能で表示するページの収集 |
| GPTBot | OpenAI | モデルの学習に使うデータの収集 |
たとえば、学習に使われたくないという理由でGPTBotを遮断するのは一つの判断です。しかし、そのつもりでOAI-SearchBotまでまとめて遮断すると、ChatGPTの検索で自社ページが出にくくなります。OpenAIも検索への表示を望む場合はOAI-SearchBotを許可するよう案内しています。robots.txtは一度書いたら見直されないことが多いので、AI検索を意識し始めた時点で一行ずつ確認する価値があります。
重要な情報がPDF・画像・後読みの中にある
ページ自体は取得されていても、肝心の情報がAIに読める形で置かれていないケースもあります。
- 料金表や仕様が画像だけで、テキストが無い
- サービス資料の中身がPDFにしか無く、HTMLのページに要点が無い
- 本文がJavaScriptの実行後にしか表示されない
- 情報がログインやフォーム送信の先にある
AI検索のクローラーがどこまでJavaScriptを実行するかは各社で異なり、公開されていない部分もあります。確実を期すなら、質問への答えになる情報はHTMLのテキストとして、最初の読み込みの時点でページに含めておくのが安全です。
内容層:取得されても引用する理由がない
質問への答えが見出しの直下に無い
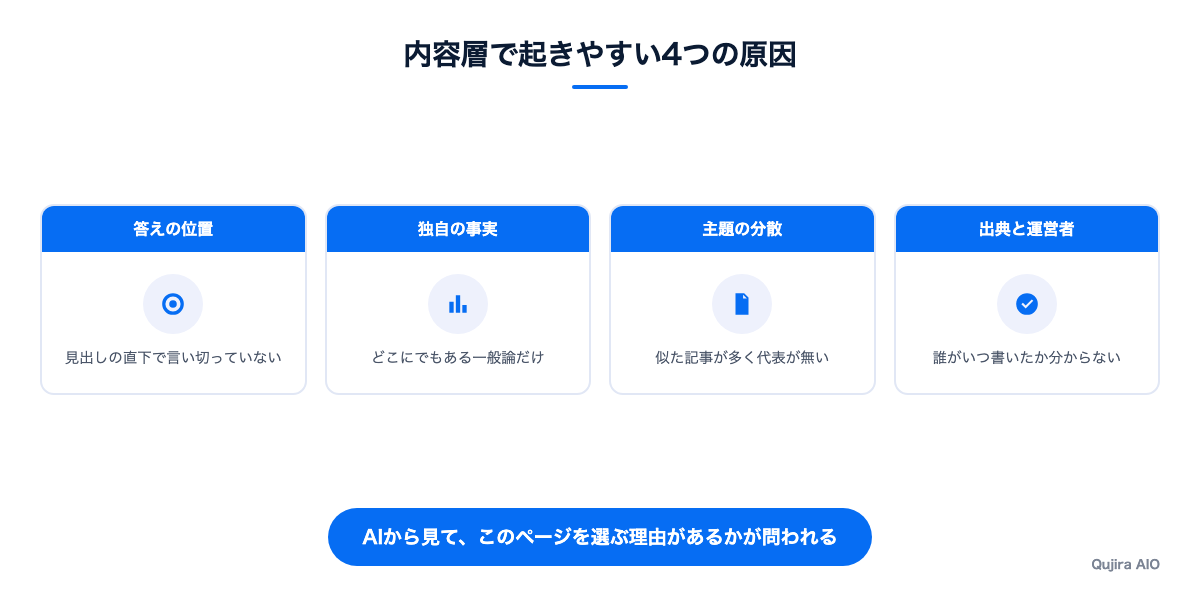
AI検索は、利用者の質問に答える文章を組み立てるために情報を探しています。ページの中に答えがあっても、前置きや背景説明の後ろに埋もれていると、答えとして使いにくいページになります。
見出しで問いを立てたら、その直後の1〜2文で答えを言い切る。この形にそろえるだけで、ページのどこに何が書いてあるかが明確になります。人間の読者にとっても読みやすい形なので、AI向けの特別な書き方と考える必要はありません。「〜とは」の見出しの下で歴史の説明から入る、比較の見出しの下で比べる前の前提を長く書く、といった構成は見直しの対象です。
一般論ばかりで独自の事実が無い
Googleは生成AI機能についての案内の中で、他のページを再編集しただけではない、経験や専門知識に基づく独自性のある内容を重視すると説明しています。AIから見ると、どのサイトにも書いてある一般論は、どのサイトから引用しても同じです。その場合は、より知られた媒体や、情報がまとまっている媒体が選ばれやすくなります。
自社サイトにしか無い事実とは、たとえば次のようなものです。
- 自社で集計した数値や、対応件数から見える傾向
- 料金や納期、対応範囲などの具体的な条件
- 実際の手順や、現場で判断している基準
- 失敗例や、向いていないケースの説明
特に料金や条件は、自社が一次情報の出どころそのものです。ここを「お問い合わせください」で済ませていると、AIは料金を聞かれたときに他社のまとめ記事を使うことになります。
似た記事が多く、主題が分散している
同じテーマの記事を少しずつ切り口を変えて量産していると、どのページがそのテーマの代表なのかが曖昧になります。似た内容のページが5本あると、それぞれが薄く評価され、どれも決め手にならない状態になりがちです。
対策は、テーマごとに代表になるページを1本決め、ほかの記事の内容をそこへ統合するか、役割の違いを明確にすることです。記事の本数を増やすことが目的になっているなら、一度立ち止まって棚卸しをしたほうが結果につながります。
出典・更新日・運営者の情報が無い
誰がいつ書いた情報なのかが分からないページは、事実の確認がしにくいページです。統計や制度の説明で出典の調査名や発表元が書かれていない、更新日が無い、会社概要が別ドメインにあって運営者が結び付かない、といった状態は、内容の良し悪し以前の問題として見直しておきたい点です。
ここまでの内容層の原因は、自社でも確認できますが、自社のページを客観的に見るのは意外と難しいものです。
外部露出層:自社サイトの外で語られていない
AIが参照する媒体に自社の名前が無い
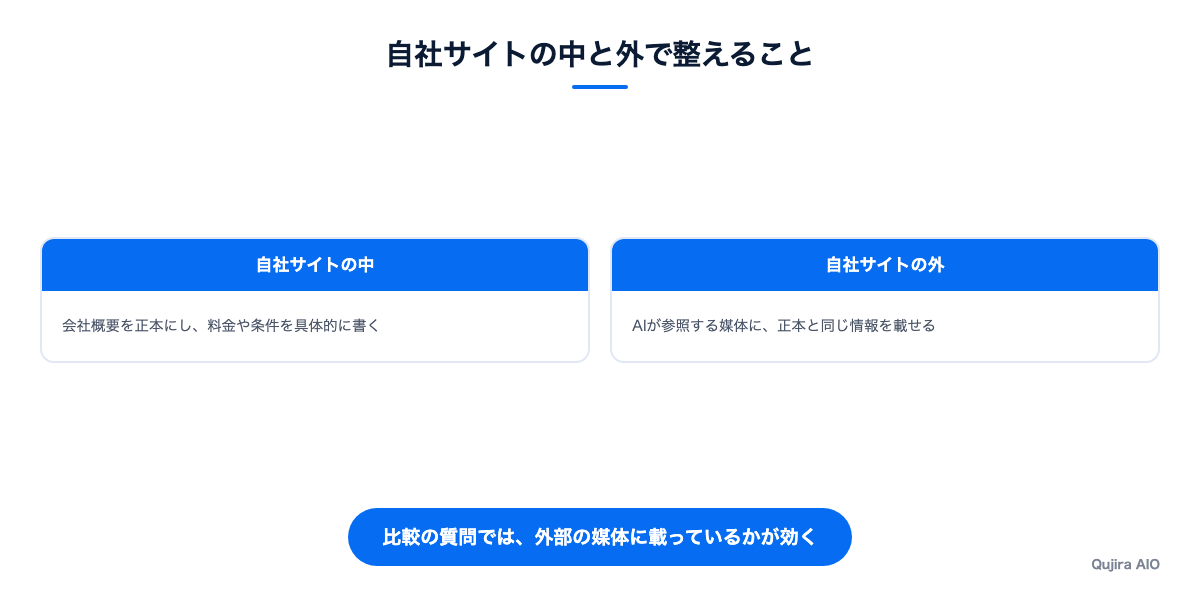
「おすすめの〇〇は」「〇〇の会社を比較すると」といった質問では、AI検索は比較記事や業界メディア、口コミサイトなど、複数の会社を扱う媒体を参照することが多くなります。自社サイトは自社のことしか書いていないので、比較の質問に対しては、第三者の媒体のほうが答えとして使いやすいからです。
この場合、自社サイトをいくら整えても、比較の答えに自社が入るかどうかは、参照される媒体に自社が載っているかどうかに左右されます。まず自社の領域の質問でAIがどの媒体を出典にしているかを調べ、その媒体に自社の情報が載っているかを確認します。
会社名・サービス名・説明が媒体ごとにばらばら
外部の媒体に載っていても、会社名の表記やサービスの説明が媒体ごとに違うと、AIがそれらを同じ会社の情報として結び付けにくくなります。
| 確認する項目 | よくあるずれ |
|---|---|
| 会社名・サービス名 | 略称、英字とカナの混在、旧サービス名が残っている |
| 事業内容の説明 | 媒体ごとに一言説明が違い、何の会社か定まらない |
| 所在地・連絡先 | 移転前の住所や古い電話番号が残っている |
| 料金・提供条件 | 改定前の料金が外部の記事に残っている |
自社サイトの会社概要を正本として決め、プレスリリース配信サービス、業界団体の会員ページ、求人媒体、地図サービスなどの登録情報をそれに合わせていきます。地味な作業ですが、AIが自社を説明するときの材料を正しくそろえる作業です。
外部での言及は短期間では作れない
第三者の媒体に取り上げてもらうことは、自社で完結しない作業です。掲載の打診から公開までに時間がかかり、公開後に検索エンジンやAIに拾われるまでにもさらに時間がかかります。お金を払って大量の記事に自社名を入れてもらうような方法は、媒体側の信頼を損ねるうえ、検索エンジンのスパムに関する方針にも抵触しかねません。
現実的なのは、実際に自社を扱う理由がある媒体に、正確な情報を提供していくことです。取材や寄稿の依頼に応える、比較記事の運営者に最新の料金や条件を伝える、業界の調査に協力するといった積み重ねが、外部露出層の改善になります。
原因を切り分ける診断手順と直す順番
質問リストを作り、定点で観測する
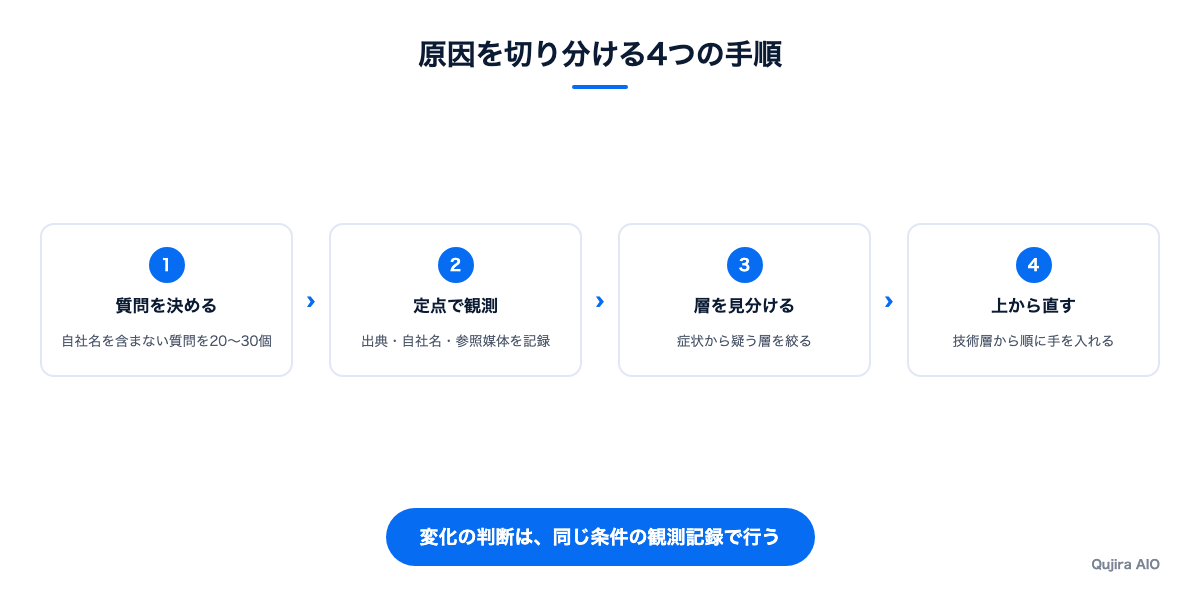
最初に、自社が引用されてほしい質問を20〜30個ほど書き出します。自社名を含まない質問が中心です。サービスの比較、料金、選び方、手順、トラブルの解決など、見込み客が実際に聞きそうな形にします。
そのうえで、使われている主なAI検索ごとに質問を投げ、次の3点を記録します。
- 自社ページが出典に入っているか
- 自社名が回答の本文に出ているか
- 出典に入っているのはどの媒体か
3点目が特に重要です。出典に並ぶ媒体が自社と同じような事業会社のサイトなら、内容層で勝負できる質問です。比較メディアや口コミサイトばかりなら、外部露出層の対策が必要な質問だと分かります。
症状から原因の層を見分ける
観測の結果を見ると、症状ごとにおおよその層が絞り込めます。
| 観測した症状 | 疑う層 | 最初に確認すること |
|---|---|---|
| どの質問でも自社ページが一度も出典に出ない | 技術層 | インデックス、スニペット設定、robots.txt |
| 特定のAI検索でだけ出ない | 技術層 | そのAI検索のクローラーの許可状況 |
| 通常検索では上位なのにAI検索では出ない | 内容層 | 答えの位置、独自の事実の有無 |
| 自社名で聞くと誤った説明が返る | 外部露出層 | 外部の登録情報と自社サイトの表記 |
| 比較の質問で自社だけ候補に入らない | 外部露出層 | 出典の媒体に自社が載っているか |
もちろん、一つの症状に複数の層が絡んでいることもあります。その場合も、上の層から順に潰していくと判断を誤りにくくなります。
直す順番と効果が見えるまでの期間
層ごとに、手を入れてから変化が見えるまでの期間が違います。技術層の設定変更は、再クロールされれば比較的早く反映されます。内容層の書き直しは、ページが再評価されるまで数週間から数か月かかることがあります。外部露出層は、媒体への掲載そのものに時間がかかるため、さらに長い目で見る必要があります。
この違いがあるので、実務では次の順番で並行して進めるのが現実的です。まず技術層を短期間で確認して片付ける。次に、代表ページを決めて内容層の書き直しを始める。それと同時に、時間のかかる外部露出層の仕込みにも着手しておく。どの層も、変化を判断するのは定点観測の記録です。
当社のAIO対策代行も、この考え方で組み立てています。やることは、コンテンツをAIが引用できる形に直すことと、AIが引用している媒体に載せにいくことの2つです。引用されることは保証できないため、責任を持つのは実行した作業の量と、毎月のレポートでの報告です。
よくある質問
構造化データやllms.txtを入れれば引用されるようになりますか
それだけで状況が変わることは期待しないほうが安全です。Googleは、AIによる概要などに表示されるためにAI専用の構造化データや特別なファイルは必要ないと説明しています。構造化データは、ページに書いてある事実を機械に正確に伝える補助として有効ですが、本文に無い価値を足すものではありません。技術層と内容層の確認を先に済ませてから検討するのが順番です。
通常の検索で上位なのに、AI検索で引用されないのはなぜですか
AI検索は、検索順位の高いページをそのまま引用するわけではなく、質問に答える文章を作るのに使いやすい情報を選びます。上位のページでも、答えが本文の奥にある、一般論ばかりで他のページと差が無い、といった場合は選ばれにくくなります。内容層の確認から始めてください。
小さな会社のサイトでも引用される可能性はありますか
可能性はあります。特に、自社が一次情報の出どころになる内容、たとえば自社サービスの料金や条件、自社の地域や業界に特化した具体的な情報は、会社の規模に関係なく参照される材料になります。反対に、大手媒体が扱っている一般的なテーマで同じ内容を書いても、選ばれる理由は作りにくいです。
対策をしてからどのくらいで変化が分かりますか
層によって違います。robots.txtやスニペット設定の修正は比較的早く反映されることがありますが、内容の書き直しや外部媒体への掲載は、数か月単位で見る必要があります。いずれの場合も、同じ質問を同じ条件で定点観測しておかないと、変化があったかどうかを判断できません。
まとめ
AI検索に引用されない原因は、技術、内容、外部露出の3層に切り分けて確認します。
- 技術層:インデックス、スニペット設定、AIのクローラーの許可を確認する
- 内容層:見出しの直下で答えを言い切り、自社にしか無い事実を載せる
- 外部露出層:AIが参照する媒体に、正確で統一された自社の情報を載せる
- どの層も、質問リストによる定点観測で変化を判断する
原因を並列に並べて片っ端から試すよりも、上の層から順に確認していくほうが、効かない作業に使う時間を減らせます。引用は保証できる性質のものではありませんが、自社側で打てる手を順番どおりに打つことはできます。