Blog
構造化データはAI検索に効くのか。実装の優先順位と書くべき中身
AI検索に自社の情報を正しく拾ってもらうために、構造化データを入れるべきか、入れるなら何から手をつけるべきか迷っている。そんな状況で「構造化データ AI検索」と調べている方に向けて書いています。
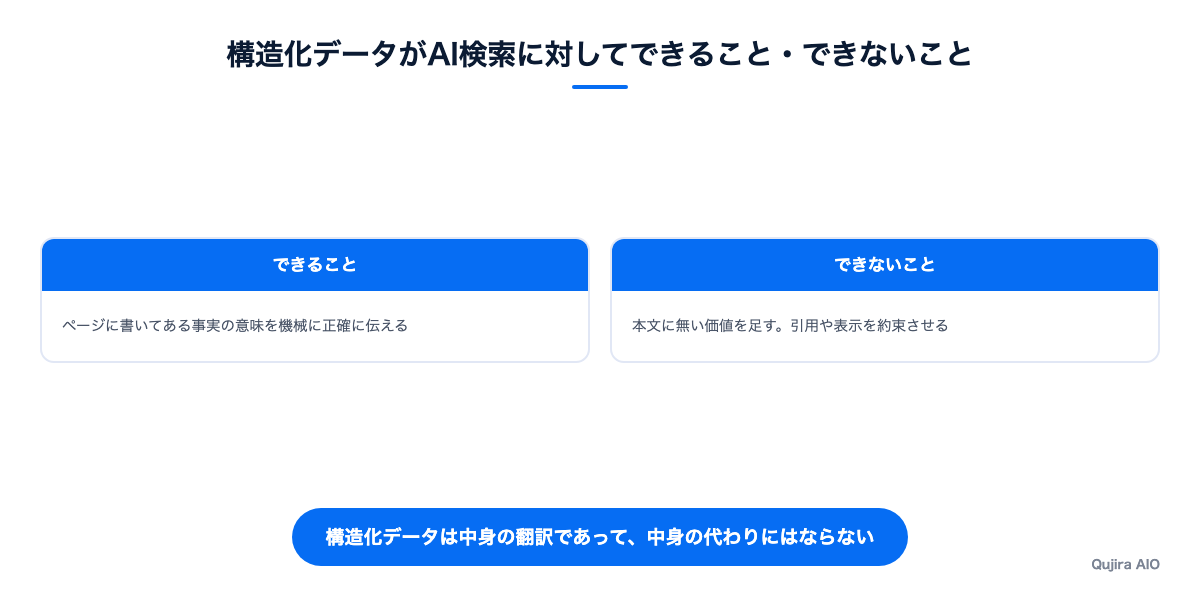
先に結論を書きます。構造化データは、ページに書いてある事実の意味を機械に正確に伝えるための仕組みです。AI検索に対しても、会社名や所在地、記事の著者、サービスの料金といった事実を取り違えられにくくする効果は期待できます。一方で、本文に無い価値を足すことはできず、入れたから引用されるという性質のものでもありません。実装の優先順位は「どのスキーマが効きそうか」ではなく、「サイトの正本情報とページに見えている内容に、どれだけ正確に一致させられるか」で決めるのが安全です。
この記事では、AI検索側が公式に説明している範囲を整理したうえで、構造化データを3段階の優先順位に分け、スキーマごとに書くべき中身、実装と検証の手順、避けたい実装までを順に扱います。当社はAIO対策代行を提供しており、診断の中で構造化データも確認していますが、構造化データだけで状況が変わるケースは多くありません。その前提も含めてお伝えします。
構造化データはAI検索にどこまで効くのか
構造化データは「ページの中身を言い直す」仕組み
構造化データは、ページの内容を決まった語彙と書式で書き直し、HTMLに添えておくものです。語彙はGoogle、Microsoft、Yahoo!、Yandexが共同で立ち上げたSchema.orgを使い、書式はGoogleが推奨しているJSON-LDで書くのが一般的です。
たとえば会社概要のページに「株式会社〇〇、所在地は東京都」と書いてあれば、人間はそれが会社名と住所だと分かります。機械はそこまで確実には読み取れないため、Organizationというタイプを使って「これは組織で、名前はこれ、住所はこれ」と明示します。記事ページならArticleで「この文章の著者はこの人で、公開日はこの日」と示します。
ここで押さえておきたいのは、構造化データは本文の言い直しであって、本文の代わりではないことです。本文に書いていない情報を構造化データだけに書くことは、Googleのガイドラインでも認められていません。
AI検索側が公式に説明していること
構造化データがAI検索にどう使われるかについて、各社の説明はまだ多くありません。公開情報から分かる範囲を整理すると次のとおりです。
| AI検索 | 公式に分かっていること | 実務での受け止め方 |
|---|---|---|
| GoogleのAI OverviewとAI Mode | 表示に特別な要件や専用のマークアップは不要。構造化データはページに見えている内容と一致させるよう求めている | 通常の検索と同じ基準で整える |
| Microsoft Bing / Copilot | 海外のSEOカンファレンスで、Bingの担当者が「スキーマはMicrosoftのLLMが内容を理解する助けになる」という趣旨の発言をしたと業界メディアが報じている | 理解の補助として使われる可能性は高い |
| ChatGPTやPerplexity | 構造化データをどう扱うかの詳細は、公開されている説明の範囲では明らかにされていない | 本文そのものが読まれる前提で書く |
Google検索セントラルの「AI機能とウェブサイト」に関する説明では、AI OverviewやAI Modeに表示されるために追加で必要なことは無く、これまでのSEOの基本がそのまま当てはまるとしています。そのうえで、構造化データを使う場合はページ上の見える内容と一致させるよう書かれています。つまりGoogleは、構造化データを「AI専用の近道」ではなく「正しく理解してもらうための通常の手段」として扱っています。
構造化データだけでは引用されない理由
AI検索が回答を組み立てるときに見ているのは、質問に対する答えがページのどこにあり、その情報がどれだけ信頼できるかです。構造化データが伝えられるのは「このページは誰が書いた何の記事か」「この会社の住所はどこか」といった属性の部分で、質問への答えそのものは本文にしかありません。
そのため、構造化データを完璧に入れても、本文が質問に答えていなければ引用の候補には上がりにくいままです。反対に、構造化データがまったく無いページが引用されている例も珍しくありません。構造化データの役割は、引用されるかどうかを決めることではなく、引用されたときや名前が挙がったときに事実を取り違えられにくくすることだと考えると、期待値を外しません。
実装の優先順位は3段階で決める
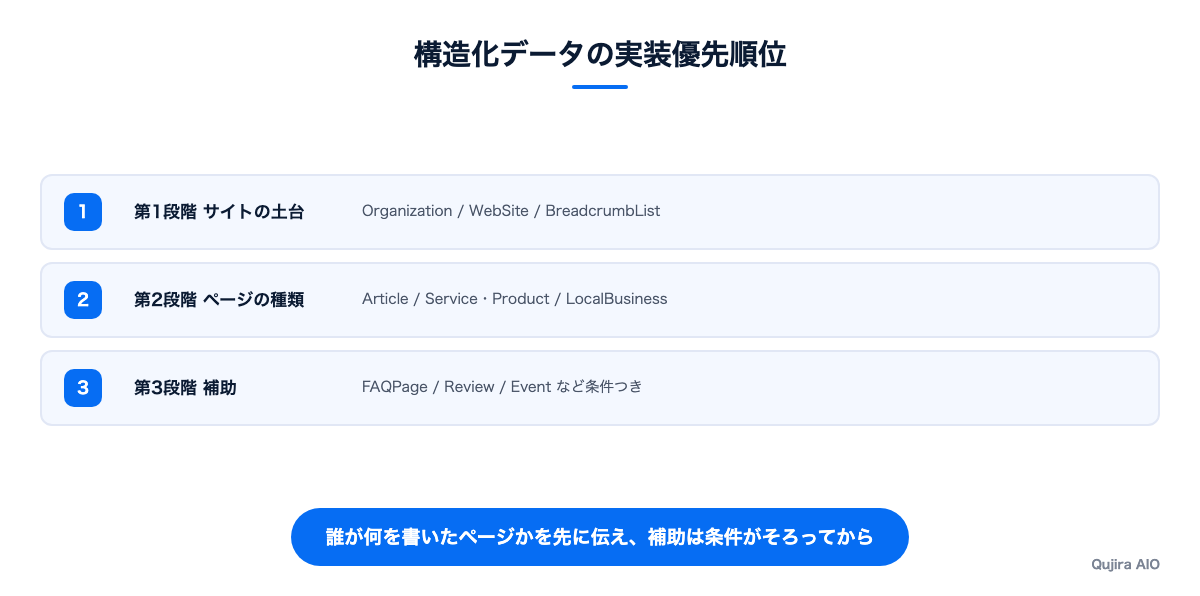
第1段階はサイト全体の土台
最初に入れるのは、サイトのどのページにも関わる3つです。
- Organization:運営している会社の名前、ロゴ、所在地、連絡先、公式SNSなど
- WebSite:サイトの名前とURL。どの組織のサイトかを示す
- BreadcrumbList:そのページがサイトのどの階層にあるか
この3つが優先なのは、AI検索にとって最も取り違えが起きやすいのが「この情報はどこの会社のものか」という部分だからです。社名が似た会社がある、サービス名と社名が違う、旧社名の情報がまだ残っている、といった状況では、Organizationで正式な名前と公式の情報源をまとめて示しておく意味があります。どれもテンプレートに一度入れればサイト全体に効くため、手間に対して得るものが大きい段階でもあります。
第2段階はページの種類を示すスキーマ
次に、ページの種類ごとにタイプを入れます。ブログやコラムならArticle、サービス紹介ならServiceやProduct、店舗や拠点があるならLocalBusinessです。
ここで大事なのは、著者、公開日、更新日、料金、提供エリアといったプロパティを、本文に書いてある値と同じにすることです。当社のブログでも、記事ページにはArticleを入れ、著者と発行者をOrganizationとして示しています。個人名の著者を立てていないのに、構造化データだけ架空の人物を著者にするようなことはしていません。
第3段階は条件がそろったときに使う補助
FAQPage、Review、Eventなどは、条件がそろったページにだけ使う補助的なスキーマです。優先順位の目安を表にまとめます。
| 段階 | 主なタイプ | 入れる条件 |
|---|---|---|
| 第1段階 | Organization / WebSite / BreadcrumbList | 全サイトで入れる。テンプレートに1回 |
| 第2段階 | Article / Service / Product / LocalBusiness | ページの種類が明確で、本文に値が書いてある |
| 第3段階 | FAQPage | 本文に質問と回答が見える形で載っている |
| 第3段階 | Review / AggregateRating | 実在するレビューを自社で集計し、ページに表示している |
| 第3段階 | Event / JobPosting など | そのページが実際にイベントや求人を扱っている |
FAQPageは「AI検索に最も効く」と紹介されることが多いスキーマです。質問と回答の組がはっきりするため、AIにとって読みやすい形になるのは確かです。ただしGoogleは以前からFAQのリッチリザルト表示を、よく知られた政府機関や医療機関のサイトに限る方針に変えており、手順を示すHowToのリッチリザルトも表示をやめています。検索結果の見た目が変わることを期待して入れるスキーマではなくなっている点は知っておいてください。引用率が数倍になるといった数字を見かけることもありますが、当社が確認した範囲では、調査の方法とセットで公開されたものは見当たりませんでした。
スキーマごとに書くべき中身
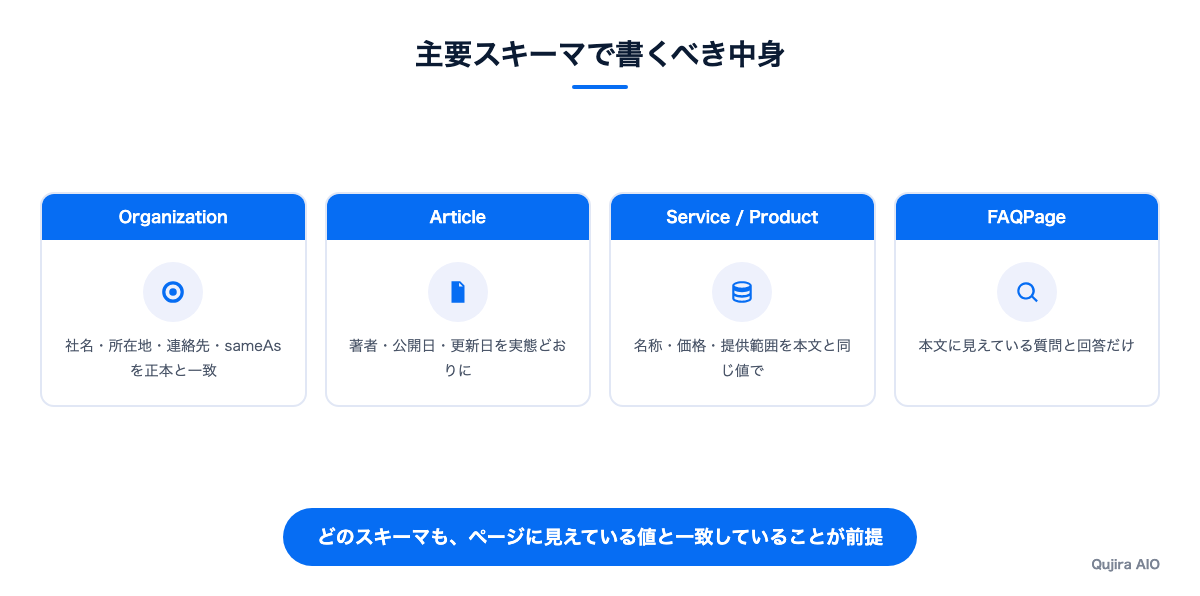
Organizationは正本情報と揃える
Organizationで書くのは、社名、URL、ロゴ、住所、電話番号、問い合わせ先、そしてsameAsです。sameAsには、公式のSNSアカウントや、業界団体の会員ページ、登記情報を確認できるページなど、同じ組織を指している外部のページを並べます。
AI検索は、自社サイトだけでなく外部の情報もあわせて読んでいます。会社情報ページ、Googleビジネスプロフィール、SNSのプロフィール、構造化データのあいだで、社名の表記や住所が少しずつ違っていると、どれが正しいのか判断できません。Organizationを書く作業は、実は社内の正本情報をひとつに決める作業でもあります。
Articleは著者と日付を実態に合わせる
Articleで特に気をつけたいのは、author、datePublished、dateModifiedの3つです。
- author:実際に書いた人か、責任を持つ組織を入れる
- datePublished:最初に公開した日。更新のたびに変えない
- dateModified:内容を実際に直した日。誤字修正だけで更新しない
- headline:ページのタイトルと同じにする
更新日だけを新しくして中身が変わっていない状態は、読者にとってもAIにとっても誤った情報になります。更新日は、情報を確認し直したときや内容を書き換えたときにだけ動かすのが原則です。
FAQPageは本文に見えている質問だけに付ける
FAQPageを入れるなら、ページ上に質問と回答が実際に表示されていることが前提です。構造化データの中だけに質問を並べたり、回答の中身をページより詳しく書いたりするのはガイドライン違反になります。
主なスキーマで確認したいプロパティを表にまとめます。
| タイプ | 最低限書くプロパティ | 一致させる先 |
|---|---|---|
| Organization | name / url / logo / address / sameAs | 会社概要ページ、各種プロフィール |
| Article | headline / author / datePublished / dateModified | 記事のタイトル、著者表記、日付表示 |
| Service / Product | name / description / offers(価格) | サービスページの料金表 |
| FAQPage | mainEntity(質問と回答) | ページに表示しているQ&A |
どの行にも「一致させる先」があるのがポイントです。構造化データは単独で正しいかどうかではなく、ページやほかの公式情報と食い違っていないかで品質が決まります。
実装と検証の手順
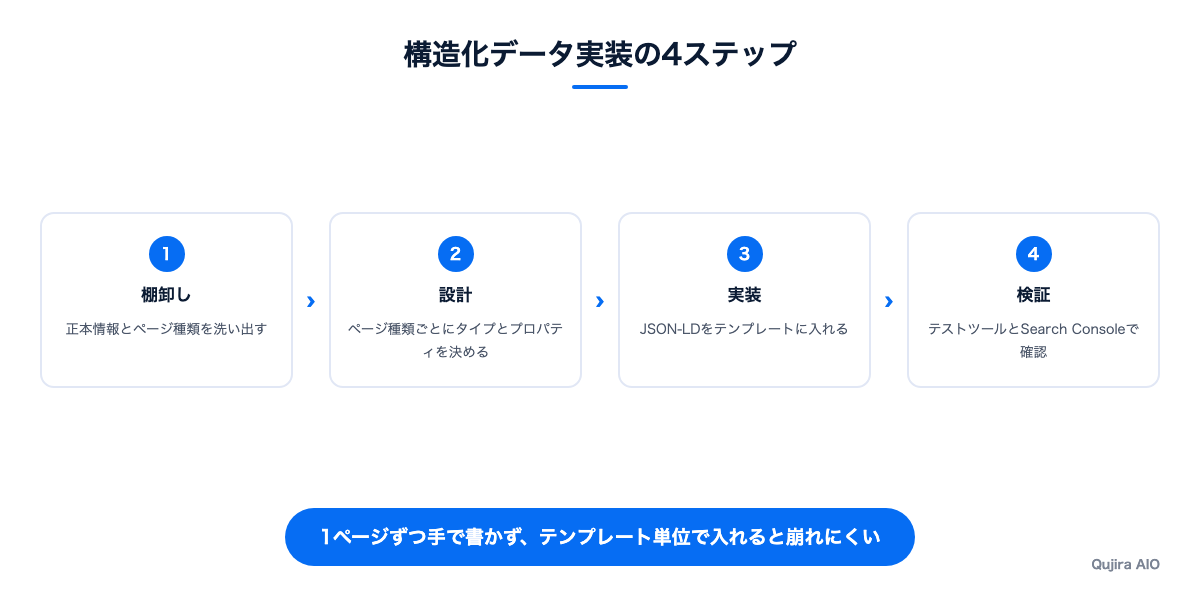
正本情報の棚卸しから始める
コードを書く前に、社名の正式表記、住所、電話番号、代表的なサービス名と料金、公式SNSのURLを一覧にします。社内でも部署によって表記が揺れていることが多いため、ここで正本を決めておきます。
あわせて、サイトのページを種類ごとに分けます。トップ、会社概要、サービス紹介、記事、問い合わせ、といった単位です。ページの種類ごとに入れるタイプとプロパティが決まれば、あとはテンプレートに落とし込むだけになります。
JSON-LDをテンプレート単位で入れる
JSON-LDは、HTMLの本文とは別にscriptタグの中へ書くため、デザインや本文を崩さずに追加できます。WordPressであればSEO系のプラグインが基本的なタイプを出力してくれることが多いので、まずはプラグインが何を出しているかを確認し、足りない部分だけを補います。
注意したいのは、プラグインとテーマの両方がOrganizationやArticleを出力して、同じページに重複や矛盾が生まれるケースです。自作のCMSやNext.jsなどで作っている場合は、記事データから著者や日付を読み出して出力するようにしておくと、手で書き写すことによるずれが起きません。
テストツールとSearch Consoleで確認する
実装したら、次の順で確認します。
- Googleのリッチリザルトテストで、エラーと警告が出ていないか見る
- Schema.orgのSchema Markup Validatorで、Google以外の観点からも文法を確認する
- Search Consoleの拡張レポートで、サイト全体のエラー件数を定期的に見る
- 料金や住所を変えたときに、構造化データも一緒に変わるかを確かめる
リッチリザルトテストはGoogleの表示機能に対応したタイプしか細かく見ないため、Organizationなど対象外のタイプはSchema Markup Validatorでも確認しておくと安心です。最後の項目は見落とされがちですが、構造化データの誤りの多くは実装時ではなく、その後の情報更新で生まれます。
避けたい実装と、効果の見方
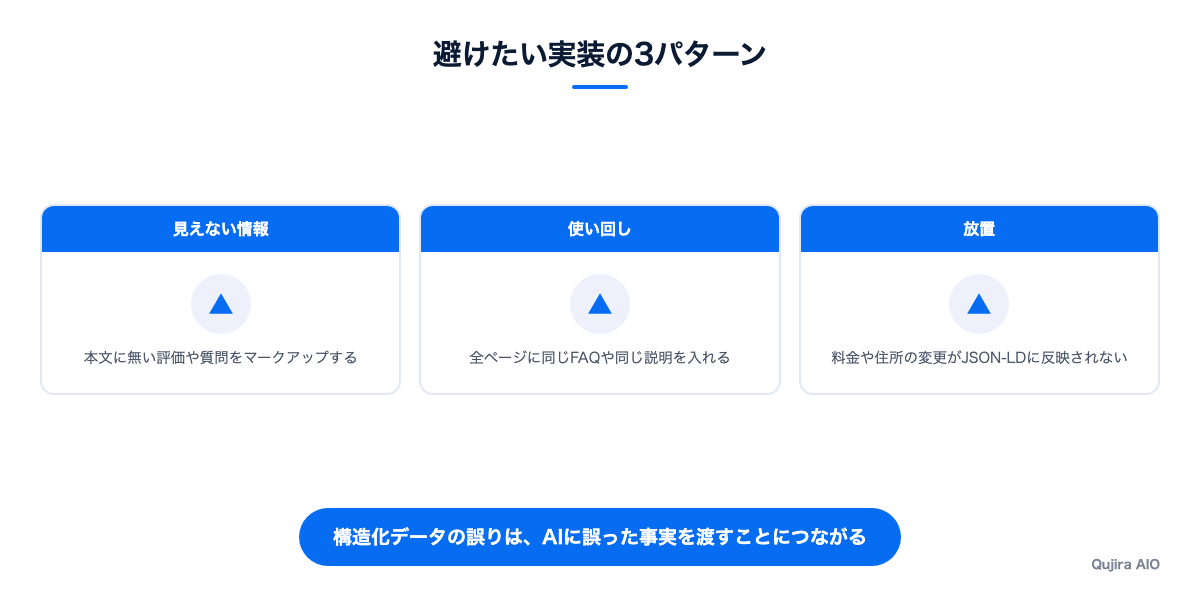
見えていない情報や使い回しのマークアップ
よく見かける問題は次の3つです。1つ目は、ページに表示していない評価や質問を構造化データにだけ書くこと。2つ目は、全ページに同じFAQや同じ説明文を入れること。3つ目は、料金改定や移転のあとにJSON-LDだけ古い値が残ることです。
どれも悪意があるわけではなく、プラグインの初期設定やテンプレートの使い回しから起きることがほとんどです。ただ、結果としてAIに誤った事実を渡すことになり、Googleからは手動による対策の対象にもなり得ます。構造化データは量を増やすより、正しい状態を保つほうが価値があります。
効果を構造化データ単体で測らない
構造化データを入れた前後で、AI検索での引用が増えたかどうかを比べたくなるかもしれません。ただ、AI検索の回答は同じ質問でも日によって変わり、本文の改善や外部での露出の変化とも重なるため、構造化データだけの効果を切り出すのは現実的ではありません。
当社では、構造化データについては「エラーが無いこと」「正本情報と一致していること」を確認項目にして、引用の変化は本文の改善や外部媒体への掲載とあわせて月次で追うようにしています。構造化データは成果を生む施策というより、ほかの施策の成果を取りこぼさないための下地と位置づけるのが実態に合っています。
構造化データより先に見直したいこと
構造化データの前に手をつけたほうが効果が見込める作業もあります。
- 質問に対する答えを、各ページの冒頭で先に書く
- 料金、対応範囲、実績など、比較に使われる事実を本文に明記する
- 会社情報を1ページにまとめ、表記を統一する
- AIが参照している比較記事や業界媒体に、自社の正しい情報が載っているか確認する
構造化データはこれらが整ったうえで効いてくるものです。順番を逆にすると、正しくマークアップされた薄いページが増えるだけになります。
よくある質問
構造化データを入れればAI Overviewに表示されますか
表示されるとは言えません。Googleは、AI Overviewに表示されるための特別なマークアップは無いと説明しています。構造化データは内容を正しく理解してもらう助けにはなりますが、表示されるかどうかは本文の内容や信頼性を含めて判断されます。
ChatGPTやPerplexityも構造化データを読んでいますか
各社は、構造化データをどう扱っているかの詳細を公開していません。ページを取得する際にJSON-LDが含まれていれば読まれる可能性はありますが、それを前提にするより、本文だけで事実が伝わる書き方にしておくほうが確実です。
llms.txtは構造化データの代わりになりますか
役割が違います。llms.txtはAI向けにサイトの概要や主要ページを案内するテキストファイルとして提案されているものですが、主要なAI検索が正式に対応すると表明した段階にはありません。構造化データはページ単位で事実を示すもので、置き換えの関係にはありません。
小さな会社でも構造化データは必要ですか
第1段階のOrganizationとWebSiteは、規模にかかわらず入れておく価値があります。会社名や所在地の取り違えは、小さな会社ほど起きやすいためです。一方でFAQPageやReviewなどの補助的なスキーマは、条件がそろうまで急ぐ必要はありません。
まとめ
構造化データは、ページに書いてある事実の意味を機械に正確に伝える仕組みで、AI検索に対しても事実の取り違えを減らす役割が期待できます。ただし本文に無い価値を足すことはできず、入れたから引用されるものでもありません。
実装は、Organization、WebSite、BreadcrumbListの土台から始め、次にArticleやServiceでページの種類を示し、FAQPageなどの補助は条件がそろったページに限って使う、という順番が安全です。どの段階でも、ページに見えている内容と社内の正本情報に一致させることが品質の基準になります。
構造化データは単独の施策ではなく、本文の改善と外部での露出を支える下地です。まずは自社の会社情報がサイト内外で揃っているかを確かめるところから始めてみてください。